Roadmap data engineer · version 1mise à jour du 12 septembre 2026
Devenir data engineer : la carte, par quelqu'un qui fait ce métier
Dix ans que j'en vis. Voici le chemin que je donnerais à quelqu'un qui part de zéro en 2026 : les bases avant la data, deux langages, un seul cloud, Spark, un orchestrateur, le DevOps qu'on oublie toujours, et l'IA dès le premier jour. Et la liste de ce que tu peux ignorer.
Trois parties, dix sections, la carte en cinq pièces puis entière, les pièges et la checklist. Ce n'est pas une carte exhaustive : c'est la carte de ce qu'on te demandera en France.
Partie 1 · Le métier, sans filtre
Avant la carte : ce que fait vraiment un data engineer, et pourquoi on n'entre pas par la porte qui porte son nom.
Pourquoi je te parle de ça
Je ne sors pas d'une école d'informatique. Je suis arrivé là par la donnée, et j'en vis depuis dix ans.
Je viens de la recherche : une thèse en microélectronique, pas une école d'info. En sortant de thèse, je me suis posé une seule question : c'est quoi mes forces ? La data, la science. J'en ai fait un métier.
Premier poste : cloud data engineer dans une ESN, trois ans. Depuis 2021, freelance, sur AWS, pour de grands groupes industriels : des pipelines qui consolident des millions de lignes chaque nuit, des jobs Spark, des orchestrations en Step Functions, des modèles derrière. Aujourd'hui je fais de l'IA générative et de la plateforme sur Google Cloud, à distance. Deux certifications AWS passées à l'époque, expirées depuis.
Ce qui suit, c'est ce que je réponds quand on me demande « comment on fait pour devenir data engineer ». Avec les technos qu'on me demande en mission, pas celles des tutos.
Ce que fait un data engineer, concrètement
Un back-end qui traite de la donnée, en prod, sur un cloud. Et la moitié de la journée, c'est de la plomberie.
Une entreprise a de la donnée partout : sa base de prod, ses outils, ses fichiers, des API. Le data engineer la déplace, la nettoie, la joint, la met à disposition. Tous les jours, sans que personne n'appuie sur un bouton. Le résultat : un entrepôt propre, où les analystes font leurs tableaux et où les modèles s'entraînent.
Ce qu'on ne voit pas sur le schéma : le job tourne à 2 h du matin, sur une machine que tu as créée avec du code, avec des droits que tu as posés. Et il casse. Un fichier arrive en retard, une colonne change de type, le cluster n'a plus de mémoire. Ton boulot, c'est que ça ne casse pas deux fois.
C'est pour ça que le cloud et le DevOps ne sont pas des options sur cette carte. C'est le métier.
Sources
une base de prod, une API, des fichiers
PostgreSQL · API · CSV
Stockage brut
on copie tout, tel quel, pas cher
S3 · Cloud Storage
Transformation
nettoyer, joindre, agréger
Python · Spark · SQL
Entrepôt
prêt pour les analystes et les modèles
BigQuery · Athena
Orchestration chaque nuit à 2 h, dans l'ordre, relance si ça casse, alerte si ça recasse Airflow · Step Functions
Infra et déploiement tout ça existe parce que du code l'a créé, et se redéploie à chaque commit Terraform · Docker · GitHub Actions
Pourquoi on n'y entre pas directement
Le poste « data engineer junior » existe peu. On y arrive depuis un autre poste.
Regarde les offres : un cloud, Spark, Airflow, Terraform, et « deux à trois ans d'expérience ». Pas parce que les recruteurs sont méchants. Parce qu'un data engineer touche à la prod : une erreur dans un pipeline, c'est un tableau faux devant un directeur, ou une facture cloud qui explose. On confie ça à quelqu'un qui a déjà livré du code en prod.
Donc l'ordre, c'est : d'abord savoir coder et déployer un back-end. Ensuite la donnée. Le premier job est souvent ailleurs : développeur back-end, data analyst, DevOps. Trois portes d'entrée, et trois roues de secours. Les compétences de cette carte se vendent aussi sur ces trois postes : si le poste data engineer ne vient pas tout de suite, tu n'as rien perdu.
Par où on entre
Développeur back-end
La voie la plus large. Tu sais déjà écrire une API, tester, déployer : il te manque la donnée.
Data analyst
Tu entres par le SQL et les dashboards. Il te manque le code et la prod.
DevOps ou cloud
Tu entres par l'infra. Il te manque la donnée elle-même : la modéliser, la transformer.
Où on arrive
Data engineer
Un back-end qui traite de la donnée, en prod, sur un cloud.
Et dans l'autre sens : si le poste ne vient pas tout de suite, les mêmes compétences vendent un job de back-end, de DevOps ou d'analytics engineer. Tu n'as rien perdu, tu attends une porte de plus.
Partie 2 · La carte, étape par étape
Cinq étapes, dans l'ordre. Chaque étape a sa pièce de carte ; la carte entière est à la fin, à télécharger.
Les bases de la base
Comprendre comment ça marche, pas apprendre les commandes par cœur. C'est ça qui a changé avec l'IA.
Le terminal, Linux, Git. Comment une requête HTTP arrive à un serveur et repart avec du JSON. Comment un back-end est fait : des routes, une base, des tests, un déploiement. Docker, assez pour lancer une base en local et emballer un job. Ce n'est pas la data, c'est le socle.
Ce qui a changé par rapport à avant : tu n'as plus besoin d'apprendre les commandes. Claude Code les connaît toutes, il les tape pour toi. Ce dont tu as besoin, c'est de la vision haut niveau : savoir qu'un conteneur, c'est une machine dans une boîte ; qu'un commit, c'est un point de sauvegarde ; qu'une API, c'est une porte avec un contrat. Pas les options de la commande. Le pourquoi et le quoi. Le comment, l'IA l'écrit, et toi tu lis ce qu'elle a écrit et tu vois si c'est faux. Sans la vision, tu ne vois rien.
Deux langages : Python et SQL. Ceux-là, tu les lis et tu les écris tous les jours, même avec l'IA. Java et Scala sont sur les cartes américaines parce que Spark est écrit en Scala et que les grosses boîtes américaines ont des équipes JVM. En France, on te demande PySpark. Le Java attendra que quelqu'un te le demande.
- mon choix, ce que je ferais aujourd'hui
- bon à connaître
- AWS un service de ce cloud
- choisis-en unun seul, pas la collection
- Java sur la carte américaine, pas ici
Étape 1 · Les bases de la base
Comprendre comment ça marche, pas les commandes par cœur : l'IA les tape pour toi. C'est ça qui a changé.
L'ordinateur et le web
- Terminal et Linux
- Git
- HTTP et API REST
- Comment marche un back-end
- Docker, les bases
- Tests
Deux langages, pas trois
- Python
- SQL
- Java
- Scala
- Go
C'est exactement le contenu du plan des 6 premiers mois : le socle dev, avec Claude Code dès le premier jour, jusqu'à un premier projet déployé.
La donnée
Ce qui te distingue d'un back-end : la donnée n'est pas un détail du produit, c'est le produit.
Les formats d'abord. CSV et JSON, c'est ce que tu reçois. Parquet, c'est ce que tu écris : en colonnes, compressé, dix fois plus petit, lu par tous les outils. Iceberg, plus tard, quand tu auras des tables de plusieurs téraoctets.
PostgreSQL à fond : jointures, index, transactions. Et modéliser un schéma : ce qui est une table, ce qui est une colonne, quelle clé. C'est la compétence qu'on teste en entretien et qu'aucun outil ne remplace.
Une seule NoSQL, pour savoir quand ce n'est pas une table qu'il faut : DynamoDB si tu es sur AWS, Firestore sur Google Cloud. Cassandra, HBase : tu ne les croiseras probablement jamais. Pandas ou Polars pour tout ce qui tient en mémoire, c'est-à-dire la plupart des jobs qu'on te demandera au début.
Étape 2 · La donnée
Ce qui te distingue d'un back-end : la donnée n'est pas un détail du produit, c'est le produit.
Les formats
- CSV et JSON· ce que tu reçois
- Parquet· ce que tu écris
- Iceberg· plus tard
Relationnel
- PostgreSQL· à fond
- Modéliser un schéma
- MySQL
NoSQL, choisis-en une
- DynamoDBAWS
- FirestoreGCP
- MongoDB
- Cassandra
- HBase
En Python
- Pandas ou Polars· tant que ça tient en mémoire
Un cloud, un seul
Les trois se ressemblent. Celui que tu choisis compte moins que le fait d'en choisir un.
AWS, Google Cloud ou Azure. Un seul, à fond, jusqu'à savoir monter un pipeline dessus les yeux fermés. Les concepts sont les mêmes partout : un stockage objet, des droits, des fonctions, un service pour lancer des jobs, un pour les enchaîner, un pour les logs. Changer de cloud plus tard, c'est apprendre de nouveaux noms, pas un nouveau métier.
Ce que je connais le mieux, c'est AWS : c'est mon terrain depuis 2018 et c'est ce que je détaille sur la carte. Google Cloud est le plus simple pour la data pure (BigQuery se prend en main en une après-midi). Azure, si tu vises les banques, les assurances et les grands groupes qui sont Microsoft partout.
Sur AWS, les services à connaître par cœur : S3 (le stockage), IAM (les droits, la moitié de tes bugs), Lambda (une fonction sans serveur), Glue (les jobs Spark gérés), Athena (du SQL sur S3), Step Functions (l'enchaînement), CloudWatch (les logs). Le reste, tu le découvriras sur le tas.
Étape 3 · Un cloud
Un seul. Les trois se ressemblent : celui que tu choisis compte moins que le fait d'en choisir un.
Choisis-en un
- AWS· mon terrain depuis 2018
- Google Cloud· le plus simple pour la data
- Azure· les grands groupes Microsoft
Les services à connaître par cœur, côté AWS
- S3AWS· le stockage
- IAMAWS· les droits
- LambdaAWS· une fonction
- GlueAWS· les jobs Spark
- AthenaAWS· du SQL sur S3
- Step FunctionsAWS· l'enchaînement
- CloudWatchAWS· les logs
- EMRAWS
Les mêmes, côté Google Cloud
- Cloud StorageGCP
- BigQueryGCP
- Cloud RunGCP
- DataprocGCP
- ComposerGCP
Entrepôt, traitement, orchestration
Là où tu deviens data engineer : les jobs qui tournent la nuit, et ce qui les enchaîne.
L'entrepôt, c'est là où la donnée finit propre. Un seul : BigQuery sur Google Cloud, Athena ou Redshift sur AWS, Snowflake si l'entreprise l'a. Le principe est le même partout : du SQL sur des fichiers en colonnes, facturé à ce que tu lis.
Le traitement : tant que ça tient en mémoire, Python. Quand ça ne tient plus, Spark, en Python. C'est la techno de l'offre d'emploi, et c'est celle qu'il faut avoir pratiquée pour de vrai : les partitions, les jointures qui explosent, le job qui prend quarante minutes parce qu'un fichier est mal découpé. dbt, pour écrire tes transformations en SQL avec des tests et de la doc. Kafka, le streaming : plus tard. La plupart des entreprises n'en ont pas besoin, et celles qui en ont besoin ont déjà quelqu'un.
L'orchestrateur, c'est ce qui fait qu'un job devient un pipeline : il lance dans l'ordre, relance quand ça casse, te réveille quand ça recasse. Airflow est le standard partout. Step Functions si tu es sur AWS, sans serveur à gérer. Composer, c'est Airflow géré par Google. Un seul, encore.
Étape 4 · Entrepôt, traitement, orchestration
Là où tu deviens data engineer : les jobs qui tournent la nuit, et ce qui les enchaîne.
Entrepôt de données, choisis-en un
- BigQueryGCP
- AthenaAWS
- RedshiftAWS
- Snowflake
Traiter
- Spark, en Python (PySpark)· quand ça ne tient plus en mémoire
- dbt· du SQL en pipeline
- Kafka· le streaming, plus tard
- Hadoop
- Hive
- Pig
Orchestrer, choisis-en un
- Airflow· le standard
- Step FunctionsAWS· si tu es sur AWS
- ComposerGCP· Airflow géré par Google
- Dagster ou Prefect· si l'équipe l'a choisi
En prod : DevOps et l'IA
Ton pipeline vit en prod. Tu es celui qui le déploie, le surveille et le répare. Et l'IA est à côté de toi dès le premier jour.
Le DevOps, c'est la moitié du métier, et c'est la moitié que les formations data oublient. Docker pour emballer un job. Terraform pour que ton infra soit du code : le bucket, les droits, le job, l'alerte, tout est dans le repo, tout se redéploie. GitHub Actions pour que chaque commit teste et déploie. Les logs et les alertes, parce que la question n'est pas si ça va casser mais quand, et si tu le sauras avant le directeur. IAM et les secrets, parce qu'un pipeline avec des droits admin est une fuite qui attend. Kubernetes : savoir ce que c'est, ne pas l'administrer, ce n'est pas ton métier.
L'IA. Claude Code écrit le job, le Terraform, les tests. Il te fait aller trois fois plus vite sur tout ce qui est écrit. Il ne sait pas que la colonne « montant » est en centimes dans un fichier et en euros dans l'autre. Il ne voit pas la facture cloud. Il ne répond pas au téléphone à 2 h du matin.
Ensuite, l'API d'un LLM devient un outil de la boîte à outils : classer des tickets, extraire des champs d'un PDF, enrichir une table. Les vecteurs et le RAG (mettre de la doc dans une base et la retrouver par sens) sont dans de plus en plus d'offres.
Étape 5 · En prod : DevOps et IA
Ton pipeline vit en prod. Tu es celui qui le déploie, le surveille et le répare.
DevOps, la moitié du métier
- Docker
- Terraform
- GitHub Actions
- Logs et alertes
- IAM et secrets
- Kubernetes· savoir ce que c'est
- Jenkins
- Mesos
L'IA, dès le premier jour
- Claude Code
- L'API d'un LLM· classer, extraire, enrichir
- Vecteurs et RAG· de plus en plus demandé
La carte entière
Les cinq pièces, collées. À garder sur ton bureau : chaque cœur est une case à cocher.
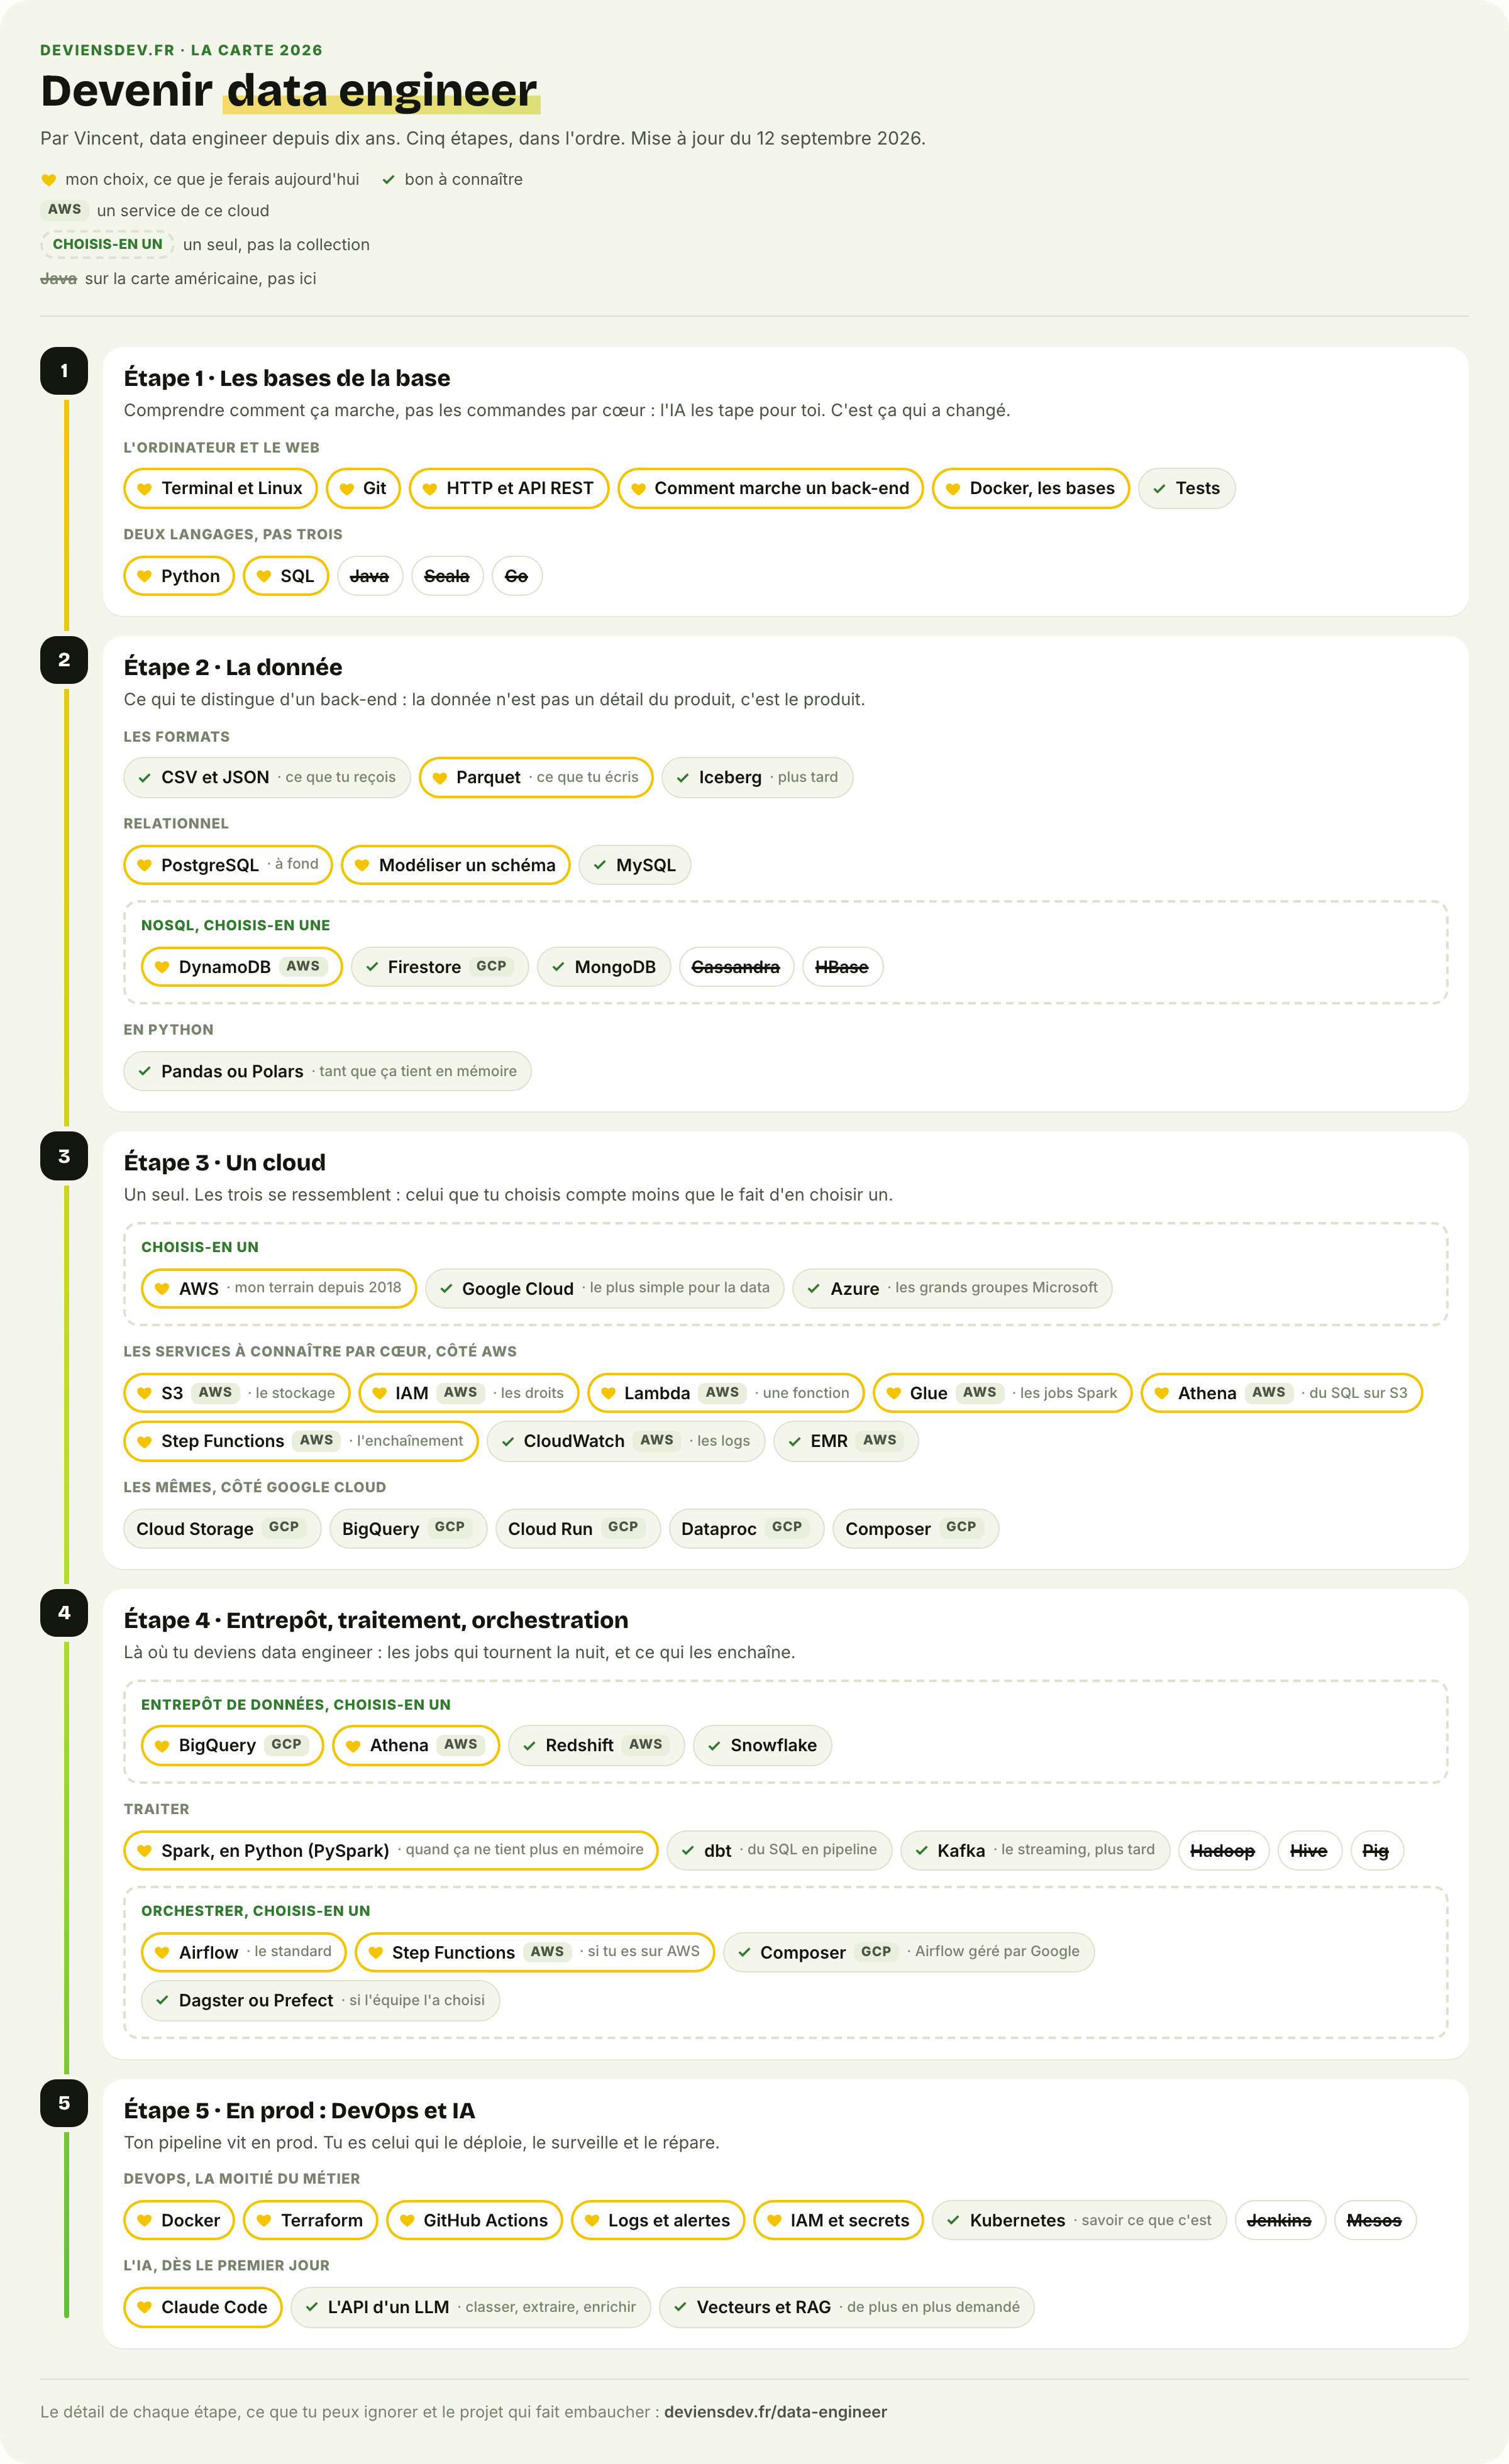
deviensdev.fr · la carte 2026
Devenir data engineer
Par Vincent, data engineer depuis dix ans. Cinq étapes, dans l'ordre. Mise à jour du 12 septembre 2026.
- mon choix, ce que je ferais aujourd'hui
- bon à connaître
- AWS un service de ce cloud
- choisis-en unun seul, pas la collection
- Java sur la carte américaine, pas ici
Étape 1 · Les bases de la base
Comprendre comment ça marche, pas les commandes par cœur : l'IA les tape pour toi. C'est ça qui a changé.
L'ordinateur et le web
- Terminal et Linux
- Git
- HTTP et API REST
- Comment marche un back-end
- Docker, les bases
- Tests
Deux langages, pas trois
- Python
- SQL
- Java
- Scala
- Go
Étape 2 · La donnée
Ce qui te distingue d'un back-end : la donnée n'est pas un détail du produit, c'est le produit.
Les formats
- CSV et JSON· ce que tu reçois
- Parquet· ce que tu écris
- Iceberg· plus tard
Relationnel
- PostgreSQL· à fond
- Modéliser un schéma
- MySQL
NoSQL, choisis-en une
- DynamoDBAWS
- FirestoreGCP
- MongoDB
- Cassandra
- HBase
En Python
- Pandas ou Polars· tant que ça tient en mémoire
Étape 3 · Un cloud
Un seul. Les trois se ressemblent : celui que tu choisis compte moins que le fait d'en choisir un.
Choisis-en un
- AWS· mon terrain depuis 2018
- Google Cloud· le plus simple pour la data
- Azure· les grands groupes Microsoft
Les services à connaître par cœur, côté AWS
- S3AWS· le stockage
- IAMAWS· les droits
- LambdaAWS· une fonction
- GlueAWS· les jobs Spark
- AthenaAWS· du SQL sur S3
- Step FunctionsAWS· l'enchaînement
- CloudWatchAWS· les logs
- EMRAWS
Les mêmes, côté Google Cloud
- Cloud StorageGCP
- BigQueryGCP
- Cloud RunGCP
- DataprocGCP
- ComposerGCP
Étape 4 · Entrepôt, traitement, orchestration
Là où tu deviens data engineer : les jobs qui tournent la nuit, et ce qui les enchaîne.
Entrepôt de données, choisis-en un
- BigQueryGCP
- AthenaAWS
- RedshiftAWS
- Snowflake
Traiter
- Spark, en Python (PySpark)· quand ça ne tient plus en mémoire
- dbt· du SQL en pipeline
- Kafka· le streaming, plus tard
- Hadoop
- Hive
- Pig
Orchestrer, choisis-en un
- Airflow· le standard
- Step FunctionsAWS· si tu es sur AWS
- ComposerGCP· Airflow géré par Google
- Dagster ou Prefect· si l'équipe l'a choisi
Étape 5 · En prod : DevOps et IA
Ton pipeline vit en prod. Tu es celui qui le déploie, le surveille et le répare.
DevOps, la moitié du métier
- Docker
- Terraform
- GitHub Actions
- Logs et alertes
- IAM et secrets
- Kubernetes· savoir ce que c'est
- Jenkins
- Mesos
L'IA, dès le premier jour
- Claude Code
- L'API d'un LLM· classer, extraire, enrichir
- Vecteurs et RAG· de plus en plus demandé
Le détail de chaque étape, ce que tu peux ignorer et le projet qui fait embaucher : deviensdev.fr/data-engineer
Partie 3 · Ce que tu peux ignorer, et comment prouver
Ce que j'ai enlevé de la carte américaine, et le seul projet qui compte pour être embauché.
Ce que tu peux ignorer
La carte américaine de 2021 a plus de cent cases. Voici celles que j'ai enlevées, et pourquoi.
| Sur la carte américaine | Ce que j'en pense |
|---|---|
| Java, Scala, Go | Python suffit. Spark se pilote en Python. |
| Hadoop, HDFS, MapReduce | C'est 2012. Le cloud a remplacé le cluster maison, le stockage objet a remplacé HDFS. |
| Hive, Pig, Impala, Presto | Remplacés par Athena, BigQuery et Spark SQL. |
| Cassandra, HBase, CouchDB, Neo4j | Des bases de niche. Tu les apprendras si une équipe les a. |
| Flink, Storm, Samza, Beam | Le streaming. Plus tard, et seulement Kafka. |
| Mesos, Docker Swarm, LXC | Morts. Docker et un service géré, ou Kubernetes si l'équipe l'a. |
| Jenkins, Pulumi, Oozie, Luigi, NiFi | Des choix d'équipe. GitHub Actions, Terraform et Airflow font le même travail et sont partout. |
| RabbitMQ, ActiveMQ | Du messaging applicatif, pas de la data. SQS ou Pub/Sub si besoin. |
| Prometheus, Datadog, StatsD | Le monitoring de ton cloud suffit pour commencer. |
| Active Directory | Le métier de quelqu'un d'autre. |
| CAP, OLTP contre OLAP, scaling horizontal | Gardés, mais comme des idées à comprendre en une heure, pas comme des chapitres. |
Le projet qui te fait embaucher
Un seul, de bout en bout, déployé. Il vaut plus que dix tutos.
Prends un jeu de données public qui change (data.gouv.fr en a des centaines : qualité de l'air, transactions immobilières, transports). Fais-le passer par toute la carte : un job qui le télécharge chaque jour, le brut sur S3, une transformation en Python ou en Spark, un entrepôt, un tableau de bord dessus. L'infra en Terraform, le déploiement en GitHub Actions, une alerte quand ça casse. Un README qui explique le pourquoi de chaque brique.
C'est ça, le CV. En entretien, tu ne réciteras pas la définition d'Airflow : tu raconteras la nuit où ton job a cassé parce que le fichier avait changé de format, et ce que tu as fait. C'est ce qu'un data engineer senior veut entendre.
Une certification aide un CV de reconverti à passer le filtre RH. Elle ne remplace pas ce projet.
Les 7 pièges
Ce que je vois chez ceux qui n'y arrivent pas, ou qui y arrivent deux fois plus lentement.
- 1
Apprendre les trois clouds. Un seul, à fond. Les concepts se transfèrent, les cases de la carte non.
- 2
Commencer par Spark. Spark sans SQL ni Python, c'est apprendre à conduire un camion avant de savoir faire du vélo.
- 3
Faire du Hadoop parce que c'est dans le tuto. C'est 2012. Le tuto aussi.
- 4
Collectionner les certifications. Une, si tu veux. Après le projet, pas à la place.
- 5
Tout faire depuis la console du cloud. Ce que tu cliques, tu ne sais pas le refaire. Terraform dès le premier bucket.
- 6
Laisser l'IA écrire sans lire. Le job tourne, le chiffre est faux, et personne ne sait pourquoi.
- 7
Ne chercher que « data engineer junior ». Back-end, data analyst, DevOps : trois portes de plus. Regarde la section 3.
La checklist, dans l'ordre
Quand tout est coché, tu n'es plus un débutant qui postule. Tu es quelqu'un qui a déjà fait le métier.
Un back-end déployé, avec une base, des tests et une CI.
Python et SQL au quotidien, sans chercher la syntaxe.
Un cloud choisi, un compte, une alerte de budget.
Un schéma PostgreSQL modélisé par toi, et une NoSQL touchée.
Un job Spark qui a vraiment tourné sur un fichier trop gros pour la mémoire.
Un pipeline orchestré, qui tourne tout seul chaque jour.
L'infra en Terraform, le déploiement en CI, une alerte qui t'a déjà réveillé.
Un README qui raconte le pourquoi, pas seulement le comment.
Des candidatures en back-end, data analyst et DevOps envoyées, en plus de celles en data engineer.
Les autres ressources
Gratuites, en français, sans email à donner.
- Le Starter Kit Claude CodeLes dix bases pour coder avec Claude Code.
- Écrire une skill Claude CodeComprendre les skills, puis écrire les tiennes.
- Se lancer en freelanceLes règles à connaître avant de quitter ton CDI.
- La compétence en TLa base large, puis une spécialité : comment choisir la tienne.
- 7 ressources gratuites pour la dataHarvard, le MIT, Google, l'État français : la liste complète, et dans quel ordre l'ouvrir.
Pour la version exhaustive, en anglais, la référence reste la roadmap data engineer deroadmap.sh. Celle-ci est plus courte, et c'est volontaire.